《AI 質性編碼工作流》原型開發計劃

你有嘗試過用 AI 來做質性研究編碼嗎?是不是覺得很有幫助,但是又覺得過程似乎不太科學、不太有系統性?今天我們要來和大家分享我們的階段成果,解答你這些問題。
所謂的質性編碼過程,簡單來理解,就是在非結構化文字中,快速萃取出能支持決策的結構化證據的過程。所謂的質性內容,例如我們海量的客服文字記錄、產品回饋問卷或者開放問答的回答。而所謂的編碼,就類似我們在這些文本中,找到並且進行重要概念的萃取動作。
而做這些動作的目的為何呢? 其實就是要整理出來我們想要瞭解的問題的可行動矩陣,回答我們的問題。
傳統質性研究常見的 5 大痛點
從這些任務中,我們就多少可以回想起、感受到以往我們在進行分析時極度耗費時間與精力的感受了吧!?
問題不是只有這些,因為這些問題沒有標準答案,所以往往也依賴分析者的主觀詮釋,有時候甚至其他人也難以複製相同的分析路徑,讓你不禁懷疑,這結果是真的嗎? 會不會是分析者的主觀偏見。
如果你有點學術涵養時,甚至會懷疑,到底整個過程是不是足夠嚴謹,最慘的是,這類研究其實高度依賴當時的情景,有時候甚至資料蒐集到一半才發現遺漏了重要變數的設計,無法輕易重新施測,容易造成時間與資源的浪費。
這問題在 AI 時代,是否有解? 學術界目前狀況如何?
質性研究 AI 輔助編碼-學界的爭議
其實學術界在 AI 興起之後,也有不少研究者積極投入實際應用的探索,但爭議不少,質疑的點也不少,我們簡單舉幾個例子:
-
幻覺 (Hallucinations)問題: AI 會有幻覺,這個是最讓人詬病的問題了,不過其實也有研究者發現,因為現在語言模型還有整體技術的進步,透過 RAG 技術與自我驗證代理,臨床文件的幻覺率可降至 1.47%。所以這個嚴重缺陷的解決之道,重點在於建立驗證工作流,而非完全否定工具。
-
反思性 (Reflexivity): 質性研究有一個最大的特性就是,研究者對於情境、內容的理解 & 詮釋,所以有不少研究者,極力反對在執行研究中使用 AI 技術。這點我們也高度認同,研究者對於內容的認識 & 詮釋,的確是整個研究最重要的靈魂,不過如果 AI 換個角度是協助研究者處理繁瑣且重複的機械式事務呢? 如果 AI 是反過來透過配置不同理論視角的子代理(如:依附理論 vs. 意義建構),並由反思代理檢查提示詞對編碼的影響,這形成了一種「結構化的反思模擬」,協助研究者突破他的個人盲點,更加深入研究議題呢?
-
編碼質量: 最後一個例子則是 AI 的編碼,雖然快速,但是有時候卻顯得不夠深入,甚至有可能有漂移現象,造成編碼結果的不一致等。
這個問題,其實根本上是流程設計可以克服解決的問題,怎麼做? 我們今天和大家分享的內容,就會提出一些核心的概念以及核心流程,讓大家理解我們的解決之道。
質性研究 AI 輔助編碼-核心概念
上述的幾個爭議問題,其實只要使用大型語言模型,加上特殊的工作流程設計,就可以解決掉一大半的核心問題。
第一個最重要的是,研究者的時間問題。質性研究的繁瑣,造成研究者有嚴重的時間瓶頸,而【編碼】以及 codebook 這兩項任務,就是第一個需要、也可以透過 LLM 的協助,來顯著提升分析效率的地方。
這裡要請大家特別注意到的是,我們強調的是輔助,不是【自動化】,這個差距很大。
一個 AI 輔助編碼最核心的流程,分為這幾個階段:
人工定義判斷框架(也就是定義 Codebook)-> Pilot 校準(人工基準測試)-> AI 候選編碼(提供 Candidate + 證據)-> 人工裁決(決定 Accept / Reject / Recode)-> 校準與稽核(Coverage audit)-> 證據矩陣輸出(Evidence + Provenance)
這些階段,缺一不可。 為何這麼說呢?
因為唯有將 AI 以及研究者,一起【嵌入】到整個流程中時,才能解決研究者的思考被 AI 綁架的問題,也才能為這個研究過程建立足夠的透明度並提升可重複性(Dependability)。
還有,這樣的人機協作流程,AI 不再只是單純【幫你編碼】,而是你的「第二編碼員」,它的功能在於幫助我們減少偏見,並激發我們的反思(Reflexivity)。
最後再加上稽核檔案的留存以及 IRR(編碼者間信度)的導入,才能全面提升研究的可信度。
解決方案介紹
理念上這麼完美,那麼實務流程該如何設計呢?
下面就是在工程面,依照上個段落提到的重要概念所設計的核心流程:
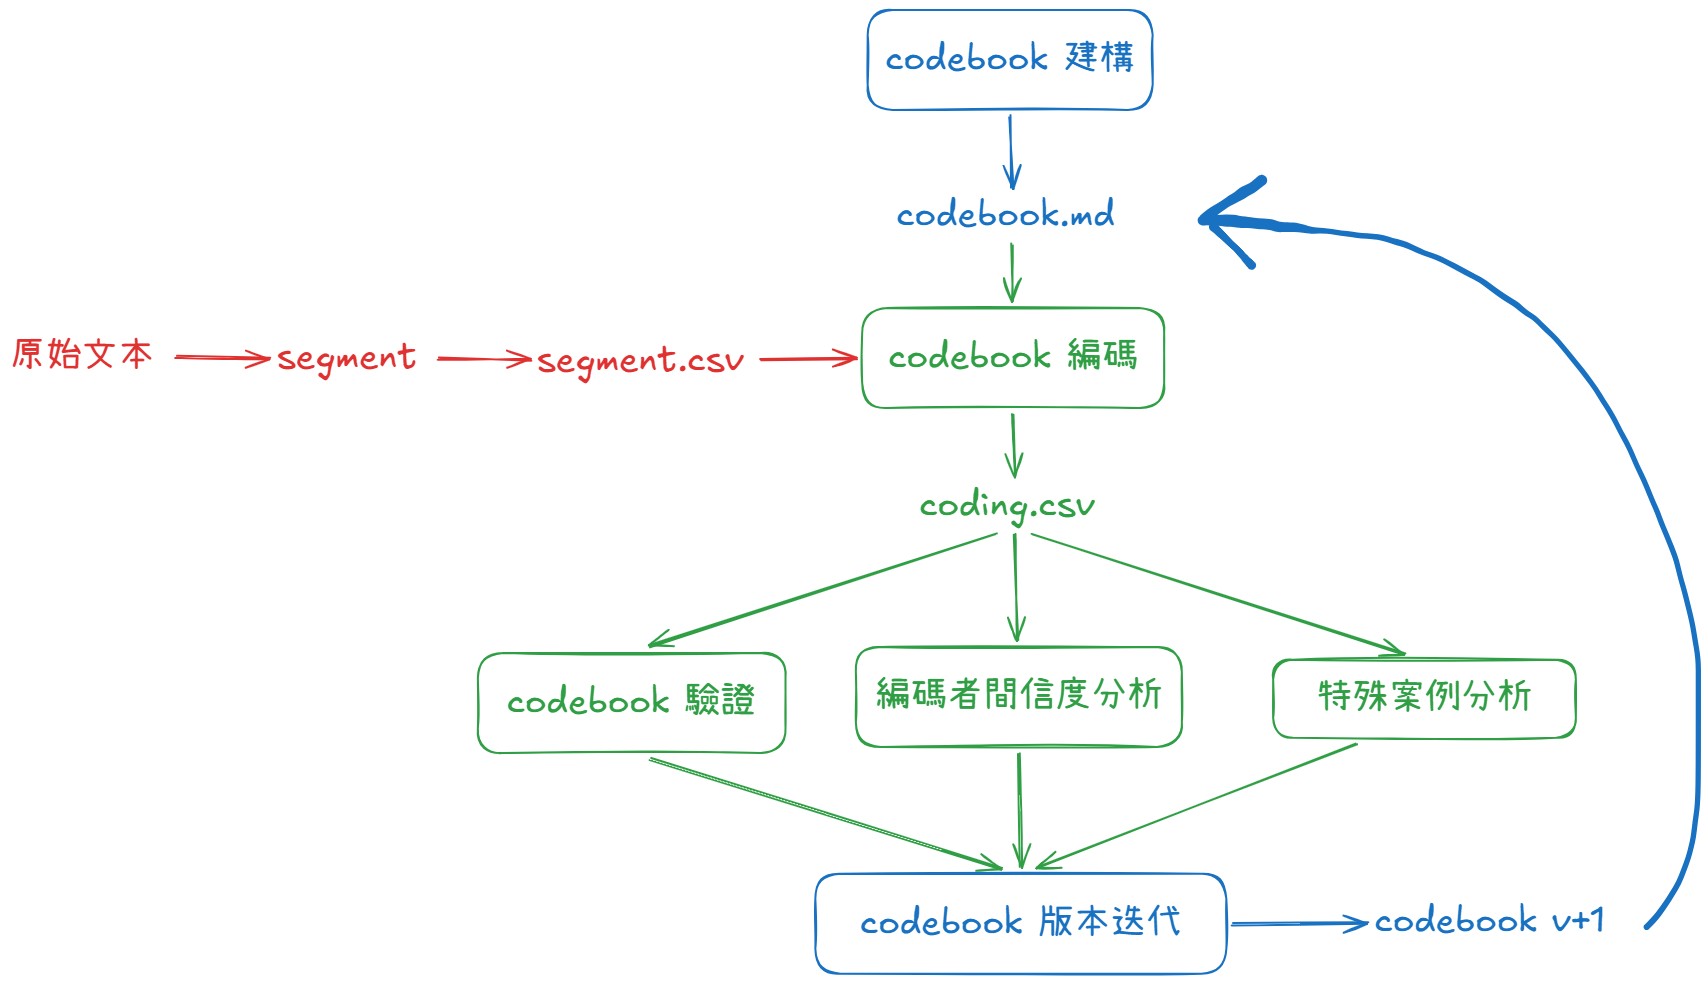
文章篇幅有限,我們就先介紹整個流程最重要的設計:
- 核心作業的模組化設計 透過 Agent Skill 的設計,將這個工作流最核心的任務,模組化為相對應的 skill,如此的設計即可讓每個研究者,即使有不同的個人研究流程,也可以動態且客製化組合屬於自己的流程。
- 模組間的資料結構設計 經過良好的任務輸入、輸出資料的結構化設計,可以讓這個流程在做動態客製化處理時,能夠更加無縫的整合。
- 作業成果的留存以及 codebook 的版本控制設計 讓 AI 的建議內容、決策細節以及最後的處理結果都以文字做稽核留存,也將最後的 codebook 整合,透過 agent skill 自動做演進版本的控管。
以上,就是我們透過 LLM 與 AI 質性編碼工作流,來回應學術研究對嚴謹度、透明度,以及研究者自身研究義務的要求。
初步成果分享(範例)
前面的流程試圖解決的主要是質性研究的傳統痛點,以及實務上質性研究學者詬病的 AI 介入問題。不過流程面的設計,其實只解決了 60% 的核心問題,還有一個在實際執行時不可忽略、但至今我們尚未解決的問題:
也就是研究者友善,也就是 UIUX 的設計問題。
雖然過程中都有資料可審查、驗證,但是就像一般通用質性軟體,往往需要提供一些讓研究人員可以透析資料、熟悉文本的工具。
所以我們最近也將整個流程,加入幾個動態生成的 dashboard,作為 UIUX 實驗,公開的成果大家可以參考下面幾個實驗結果的公開連結:
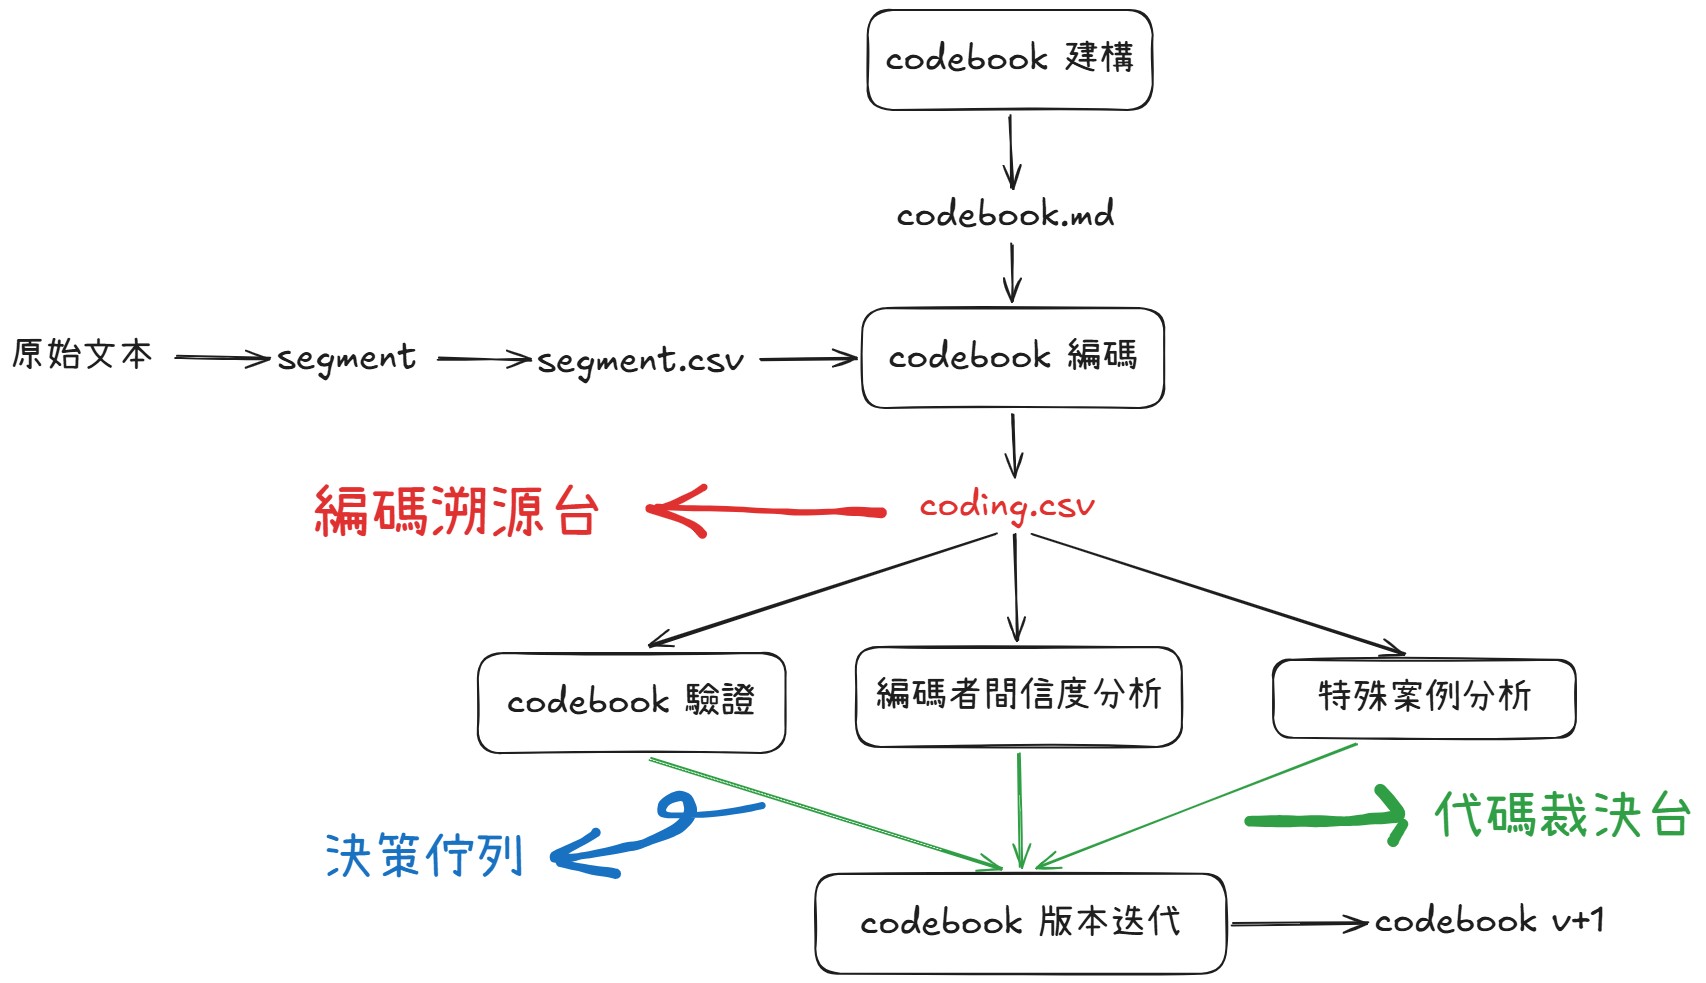 先說明,這個測試只是隨意模擬一個題目:「台灣民眾在交通政策提案中,主要反映哪些交通生活問題與改善需求?」並且從【公共政策網路參與平台】隨意找了幾筆線上的提議資料,無任何含義。
而這幾個視覺化的工具,其實也是為了補強上面幾個流程中的資料熟悉 & 決策功能,功能上目前也只是暫時達意而已,如果有什麼改進的想法,很歡迎您填寫後方我們計劃的報名表,我們會依照你的實際需求幫你設計。
AI 質性編碼工作流【原型開發計畫】報名資訊
我們這個計劃名額有限,第一階段僅限 3 名,額滿為止。
如果您目前正身陷水深火熱的編碼地獄當中,又或者每次改版 codebook 都讓你痛不欲生,相信這個 AI 質性編碼工作流,會幫你從機械化動作中解放,幫你節省大量的時間,讓你有更多時間在思索 & 詮釋上面:
https://forms.gle/CwW2dPgdL8G49LB46