我如何設計論證邏輯鏈 / 需求假設清單的 Agent Skill?

我們延續兩個星期前那篇文章的主角:一位正在準備頂尖期刊國際會議的學生。在時間極度壓縮、壓力龐大的情況下,他的論述強度不夠精確,還得反覆做「換位思考」。這篇要分享的,是我們怎麼透過 Agent,協助他釐清想法的過程,以及背後的實做細節。
以前做完這類需求,我通常直接分享怎麼幫學生設計案例的細節。這次想換個角度:除了案例本身的重要概念,我也想加上一點其他細節——我是怎麼把這個需求做成一個可以重複使用的 Agent Skill。過程中真正影響設計方向的,其實是幾個思想上的轉折,而不是技術細節本身。
第一個轉折,來自上一個沒做完的專案。
那是一位醫師要用的《投稿前引用忠實度查核》原型。做到後來我們發現,光是「把一篇文章的主張都抓出來」這件事,本身就是個大哉問——認真做下去,甚至逼我們去實做了微軟的 Claimify 主張提取器。但技術鑽得越深,越容易忘記自己一開始要解決的是什麼問題。
這次做邏輯鏈 / 假設清單分析,我決定反過來走:不求窮舉,只求覆蓋。 用 LLM 掃過文件,抓出「重要的核心論述」就好,不追求連瑣碎的論點都不放過。這句話後來直接被我寫進需求文件裡,成了整個設計的最高指導原則:
邏輯鏈分析第一個要面對的是找出該處理的論點,但是因為我們重點是找出 MVP 最重要的輪廓,所以不能也不求《窮舉》
有了這條「不做什麼」的界線,第二步才是去問 AI:如果只求覆蓋、不求窮舉,具體該怎麼做?
AI 給的答案,是把「找主張」拆成兩層。
第一層只求覆蓋:針對每一段問「這段作者主張了什麼」,不深究、不篩選,目的只是不漏掉東西。我一開始擔心這樣會漏——如果一段裡塞了三個重要主張,只抓出一個怎麼辦?後來想通了,這一層本來就不該限制數量,我們其實只求「盡量抓出這段的重要主張」,寧可雜一點,也不要在還沒看到全貌之前就先篩選。這其實是個通用的長文件處理方法:先用寬鬆、不深究的方式掃過一輪求「讀懂全貌」,再挑出真正重要的做「深入分析」——不只用在這個 skill 上。
第二層才是真正的骨幹分析:從第一層抓出的一堆主張裡,挑出真正撐起整篇論述的那幾個,只針對這些做後面的因果鏈拆解。
因果鏈怎麼拆?靠簡化版的 Toulmin 論證模型。
之所以「簡化」,是因為不需要學術辯論那套完整規格,只需要足夠定位「哪裡跳躍了」的最小結構也就是:
- Claim(主張,作者最終要讀者接受的一句話)
- Grounds(理由/證據,作者實際寫出來支持主張的內容)
- Warrant(把 Grounds 接到 Claim 的橋樑原則——這正是最常被省略不寫、也是指導教授最愛追問的那一塊)
- Qualifier(限定詞) & Rebuttal(作者是否已經處理過的例外情境),這次直接省了
有了這個結構,「因果跳躍」就有了明確的技術定義:Grounds 到 Claim 之間,Warrant 不見了,或者有寫但語焉不詳(論證理論裡叫 enthymeme,省略前提的論證)。
具體做法是對骨幹層的每個主張問一句話:「光憑這個 Grounds,還需要再加上什麼原則,Claim 才會合理成立?」補出來的那句話,就是候選的隱含前提。如果 Grounds 跟 Claim 本來就接得起來、沒有爭議,就記錄下來但不特別標記;只有當這個候選前提本身不明顯、有疑義、需要專業判斷時,才進到下一步——判斷它到底要不要說清楚。
判斷的工具,是批判性思考裡的「否定測試」(negation test)。
做法很簡單:把候選前提反過來,假設它不成立,原本的推論還站不站得住?如果推論整個瓦解,這就是必要假設;如果推論只是說服力稍弱一點,那就是加分但非必要的假設。這個測試同時把每個假設分成五種:必要假設(否定測試一戳就倒)、加分但非必要的假設(少了它推論只是變弱)、一般讀者大致能接受的常見共識、AI 自己判斷不確定、建議研究者另外查證的,以及這個領域本來就有不同立場的可能有爭議。
最後將結果整理成一行:
假設內容|支撐哪一段推論|移除後受影響的段落|分類|是否需要在前段明說
這正是之前開會提過的【假設清單】。原本「這點我不太確定」這種模糊的自我反思,現在有了「我判斷這有爭議」跟「我查過所以確定」這樣可以說清楚的標籤。
回頭看整個過程,「先求有再求精」不是一句口號,是每一步都在被檢驗的紀律。
先把需求收斂成一句「不求窮舉」,才不會在做主張萃取時一頭鑽進提取技術的細節裡出不來;跟 AI 討論、拿到建議後,我沒有照單全收,而是先把想不通的地方問清楚(比如上面那個「每段只抓一個主張,何以見得不會遺漏」的疑問),再拿一篇簡單好懂的測試文章實際跑一次,確認結果跟預期沒有嚴重落差。人工整理 AI 的意見、去蕪存菁,設計細節確認完才動手實做,實做完再用科普文、學生文獻、自己的文章三種不同的材料分別測試一次。每一步都留了一個可以喊停、重新確認方向的檢查點,這才是「先求有再求精」真正的意思:先做出一個粗糙但方向對的版本,然後在每個關卡上誠實地問「這樣做得到我要的嗎」,而不是悶著頭把功能做完。也因為守住了「只回答一個問題」這條線,這個 skill 才沒有被我做成什麼都顧的萬用工具——它跟另一個處理「讀者能不能懂敘事」的 skill 故意分開,各自只回答一種問題,需要時使用者自己跑兩次、自己整合結論。
如果你也常常需要審查一段論述、一份需求規格,這套方法或許可以直接借用。
否定測試最實用的地方,是把原本模糊的「聽起來合理嗎」的自問,變成一個可以重複執行、可以說出理由的檢查程序——不管是審自己的論文草稿,還是審一份 AI Agent 的需求規格,都適用。而五分類假設清單,則可以當成一份「知識工作的風險登錄表」:哪些假設一旦錯了,整個結論就垮;哪些只是普通共識,不用特別聲明。這兩個工具合起來,更像是把「回答前該做的推理自我檢查」,變成研究與顧問工作裡一個可以重複跑、可以教給別人的驗收流程——但終究是輔助判斷的工具,不是拿來取代思考本身。
測試報告,截圖如下:
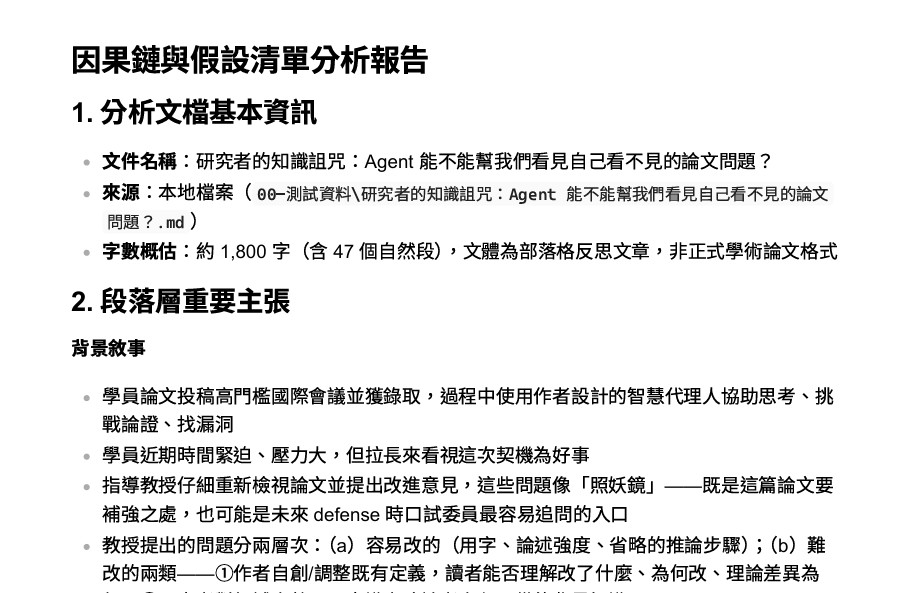
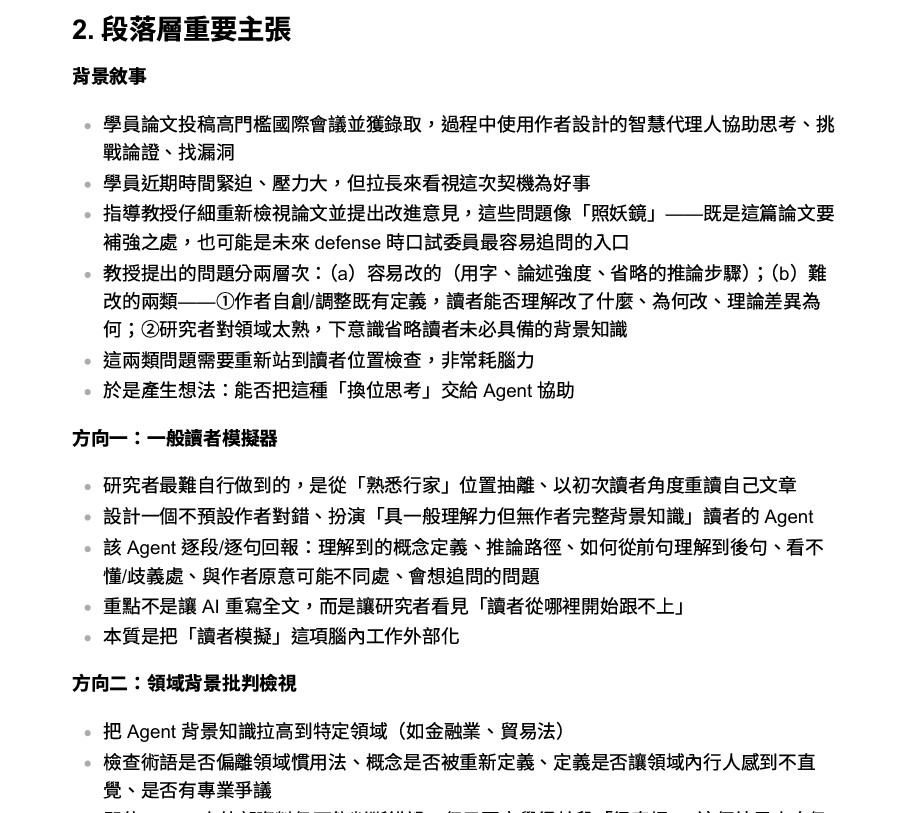
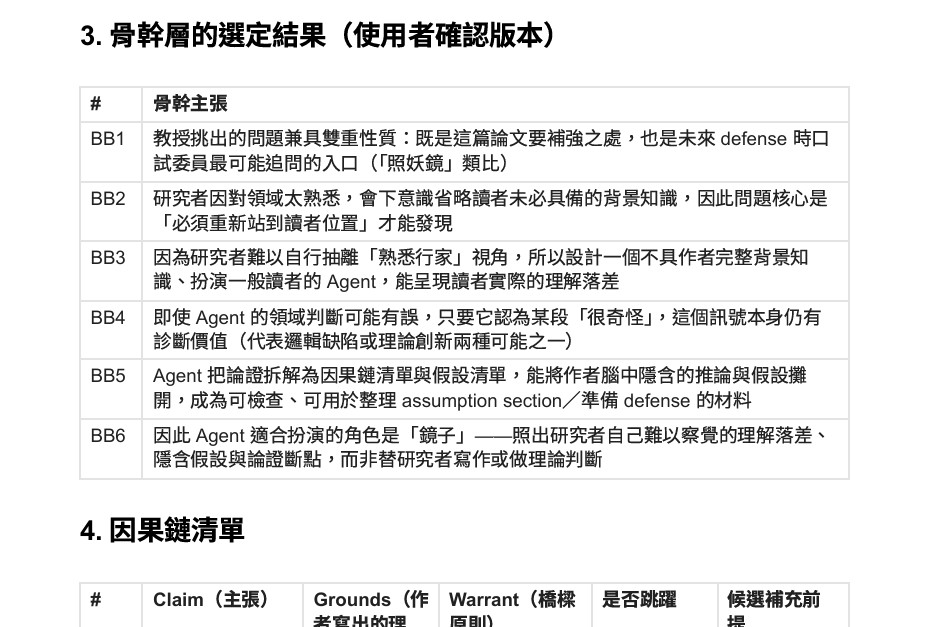
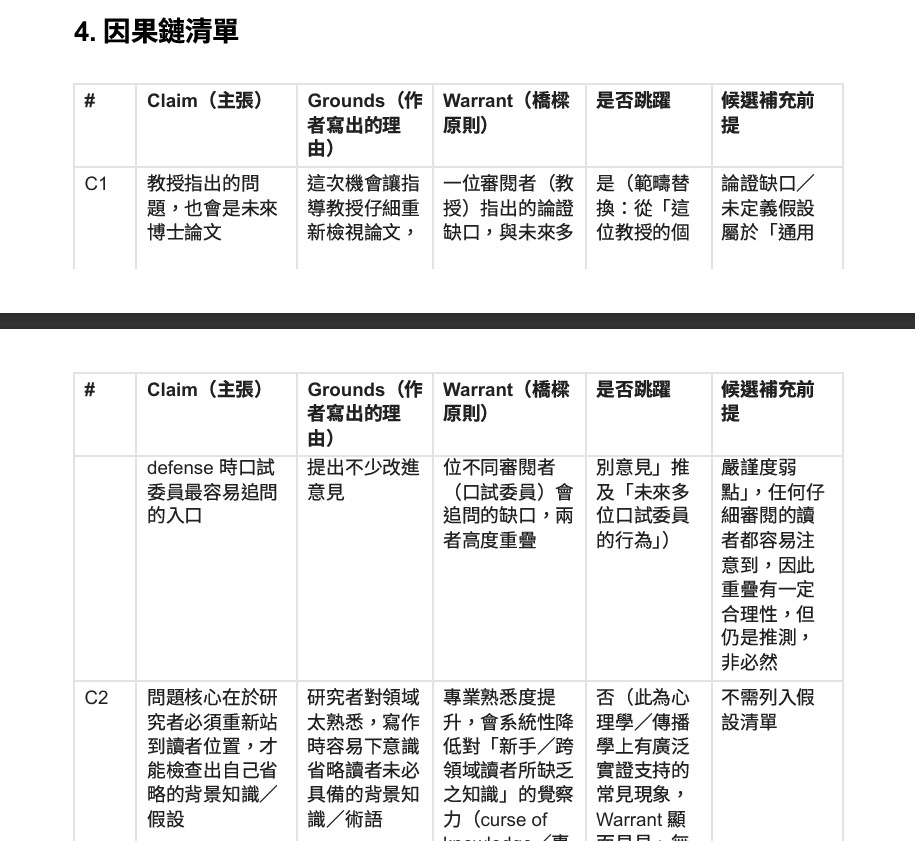
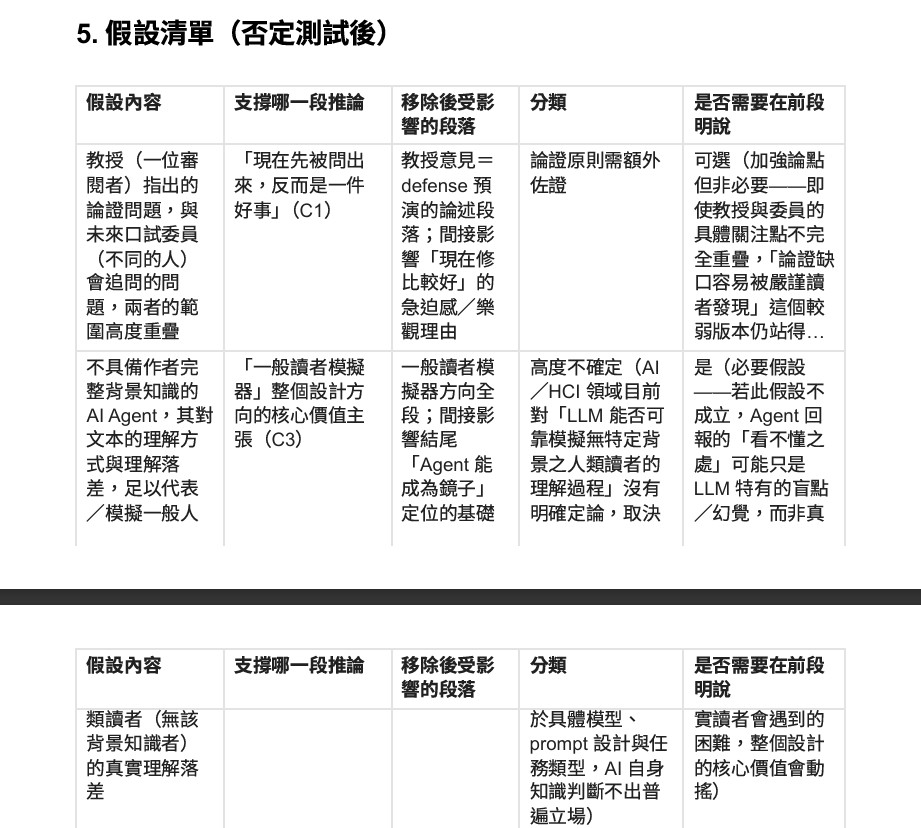
你也可以到這裏查看完整分析內容: https://drive.google.com/file/d/1NEOIIANk9VxPlZ0JSHhAsVV_B47KbdoJ/view?usp=sharing
分析對象其實就是我們的另一篇文章,原文在這: 研究者的知識詛咒:Agent 能不能幫我們看見自己看不見的論文問題?
你可以對照看看,是不是真的有邏輯跳躍之感 & 分析內容的正確性。