選了框架分析,資料卻「超框」了?你缺的不是編碼技巧,而是這套判斷流程

這是一位學員來跟我們求救的現況。
他的狀況是,原本以為已經有了理論框架,分析應該會比較好上手;沒想到真正進到資料裡才發現,超出框架範圍的內容相當多,還是免不了要額外進行主題分析——問題反而變成不知道該怎麼把兩邊的分析整合起來。
不知道你是不是也遇過類似的狀況?當時你是怎麼處理的?
其實這個問題的根源,不是「不會編碼」,而是卡在「既有框架之外的新主題,該如何被發現、判斷與納入分析」。
如果只是用最陽春的方式直接問 AI,AI 偶爾確實能幫忙找出新主題;但就算找到了、看起來也像是新主題,卻不敢用、沒有信心用——最根本的原因,是缺乏一套可以驗證 AI 判斷、追溯分析依據的工作流程。
還有一點,我們從這位學員身上也看到:
我也用了 NVivo,可是遇到這些該進行主題分析的內容,還是不知道該怎麼辦。這是怎麼回事?
那 NVivo 還缺了什麼?對這位學員來說,他缺的不是「存放編碼的地方」,而是「如何判斷框架外的新主題是否成立」。也就是說,雖然 NVivo 可以讓他建立一個叫做「框架外主題」的 node,但它不會自動幫他回答:
- 這是新主題,還是既有 code 的變體?
- code 的定義是否太模糊?
- 哪些特殊案例、反例或邊界案例值得注意?
這類問題——而這正是我們《AI 質性編碼工作流》要解決的核心缺憾。
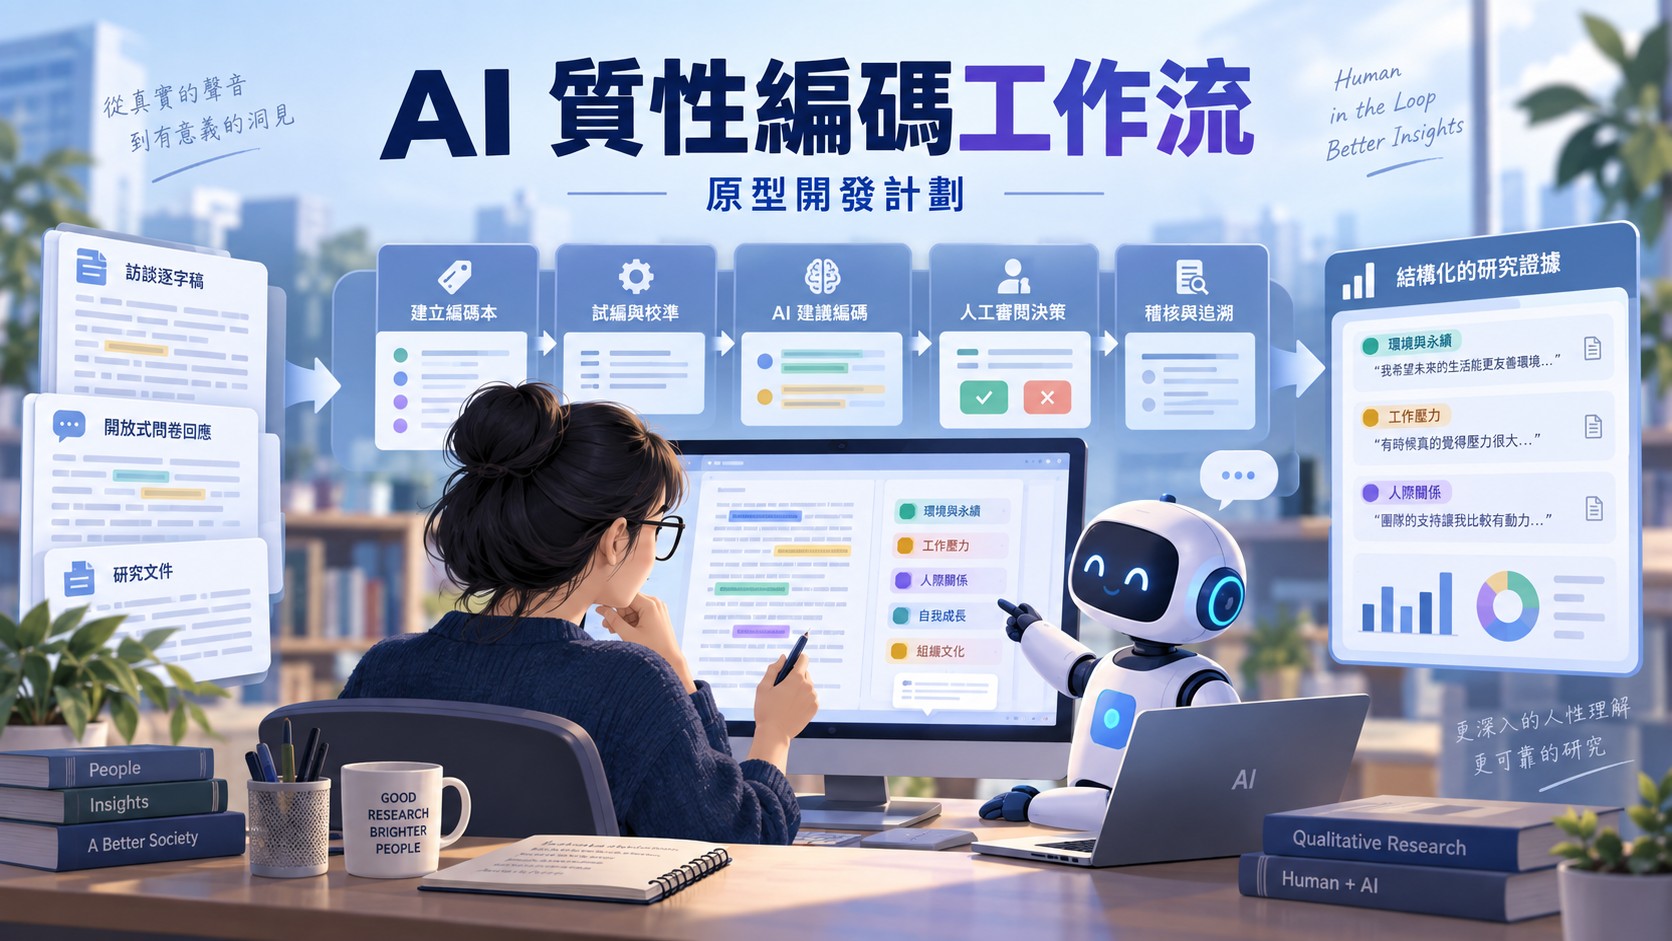
我們的《AI 質性編碼工作流》,核心價值是在你做出研究決策之前,補上 NVivo 缺漏的「分析流程控制」,並提供嚴謹研究最重要的品質檢查與稽核溯源功能。這些設計的重點,不是要幫你做「自動編碼」,而是要在你進行分析時,扮演你的思考夥伴。所以我們與研究者,還有像 NVivo 這類的質性資料分析管理平台,三者之間的分工,大致是這樣的:
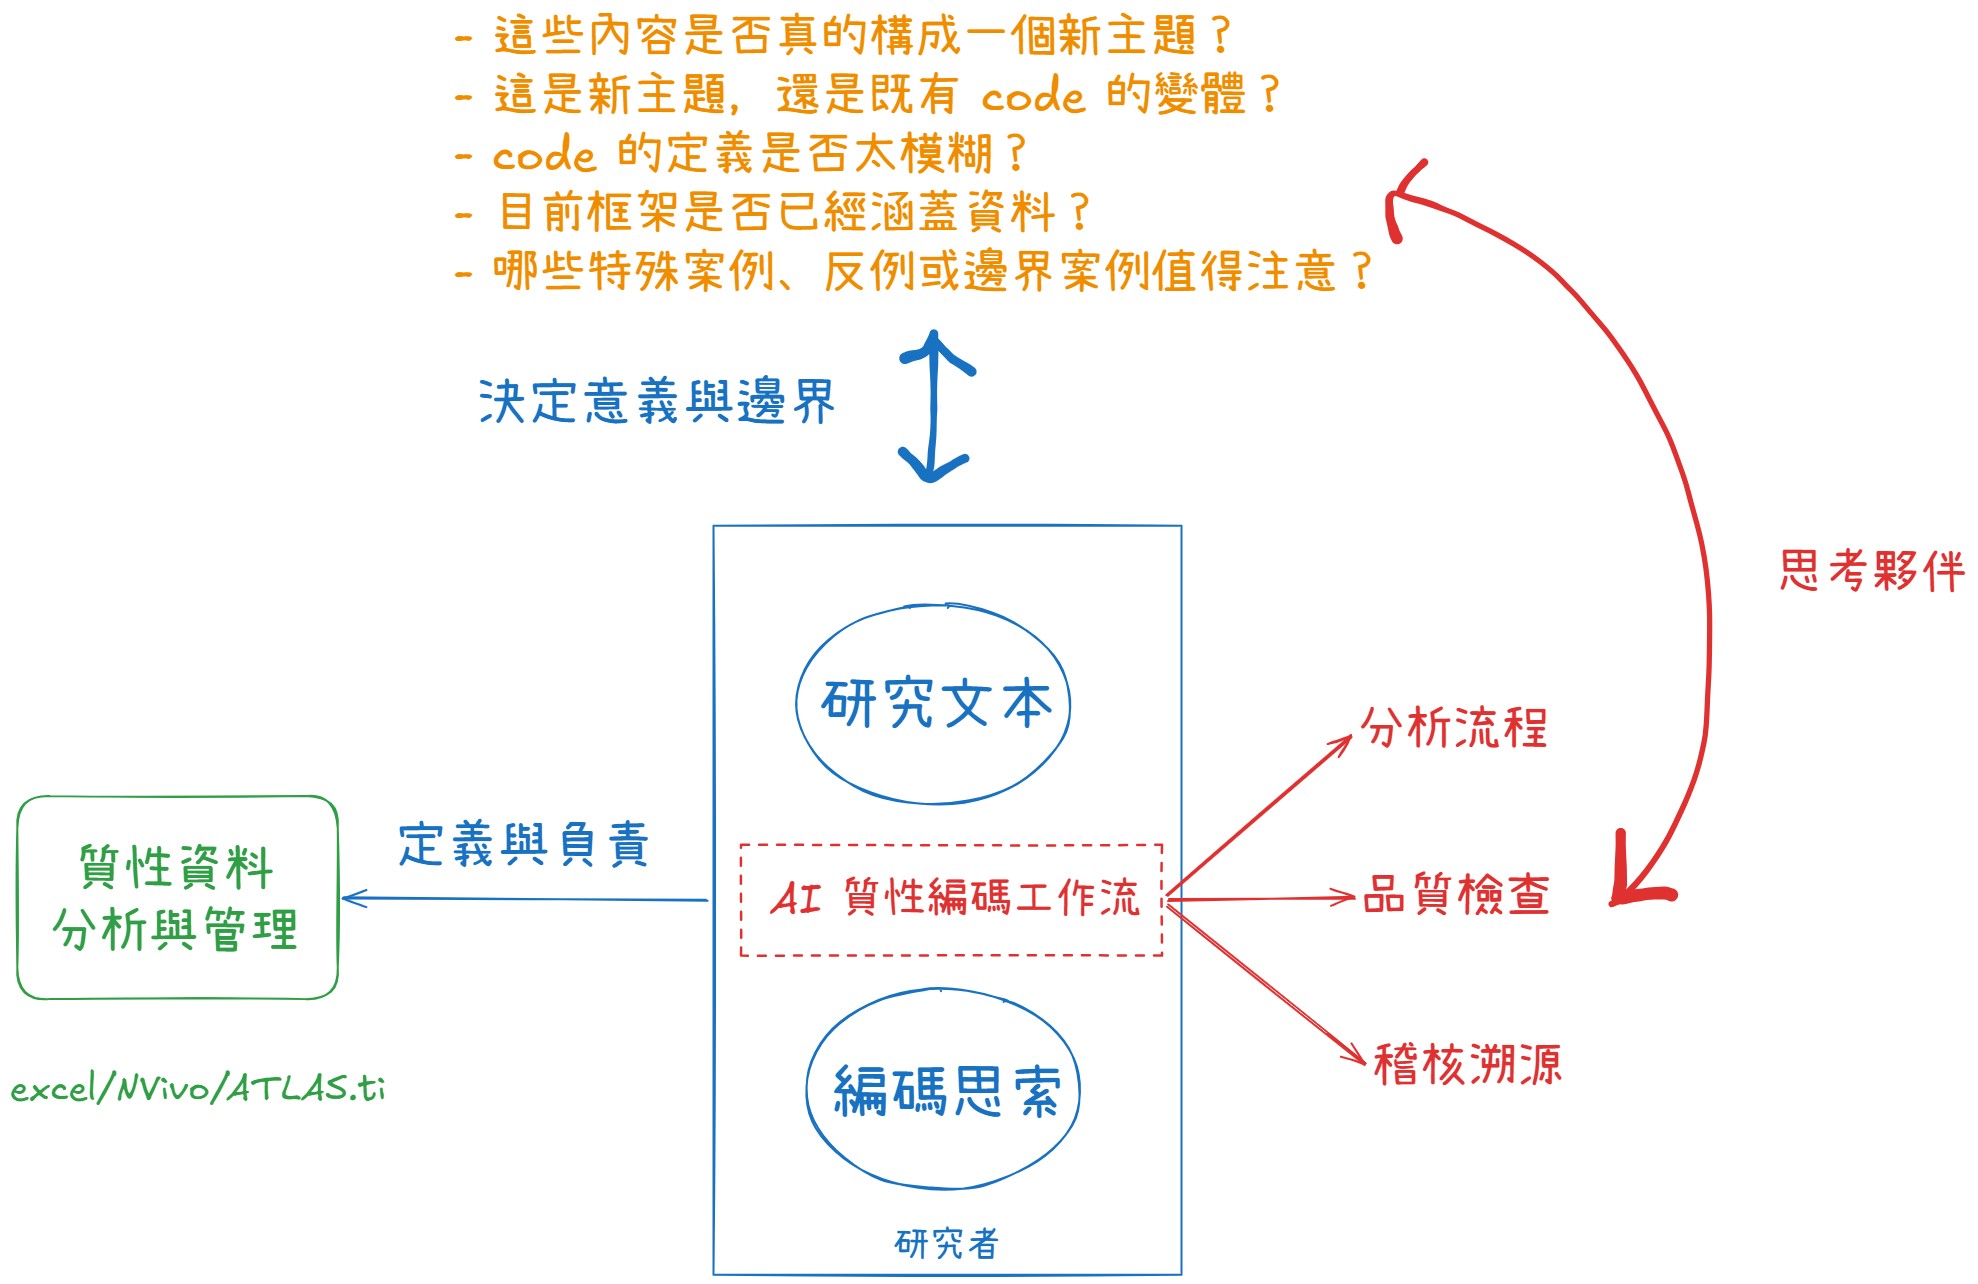
至於實際的工作細節是怎麼互補的呢?我們直接列表給大家,讓大家可以更一目瞭然地理解:
| 分析工作 | 研究者 | AI 質性編碼工作流 | 質性資料分析管理平台(excel/NVivo/ATLAS.ti) |
|---|---|---|---|
| 研究問題與理論框架 | 定義與負責 | 協助整理 | 保存研究資料 |
| Codebook | 決定意義與邊界 | 建立、規範、版本化 | 建立 node 結構 |
| Pilot | 提供人工判斷基準 | 檢查 codebook 是否清楚、完整 | 協助人工編碼 |
| AI 編碼 | 審核結果 | 提出候選編碼、證據、信心與旗標 | 可視需要做自動編碼 |
| 框架外主題 | 決定是否納入 | 掃描、聚類、提出候選主題 | 建立與比較新 node |
| 特殊案例 | 解釋其研究意義 | 找出 borderline、negative、outlier cases | 查閱與整理證據 |
| 分析備忘 | 撰寫最終詮釋 | 協助形成 memo 結構與溯源 | 保存 memo、連結資料 |
| 最終成果 | 對研究結論負責 | 產出 audit package | Framework Matrix、query、報表與展示 |
希望透過這位學員遇到的問題,做更進一步的說明,能讓大家更清楚我們的角色定位。
最後,這次《AI 質性編碼工作流》的限時限量合作機會,總共只開放 3 個名額,報名將於 2026 年 10 月 8 日截止(額滿則提前停止收件),有需要的朋友請盡快報名: