研究者的知識詛咒:Agent 能不能幫我們看見自己看不見的論文問題?

上個星期和一位學員進行需求訪談時,聽到了一個讓人很高興的消息。
他先前投稿了一個門檻相當高的國際會議,原本只是抱著「試投看看」的心情,沒想到最後真的錄取了。第一時間當然很替他高興。
後來和他深入聊了一下,自己其實也有一點欣慰:之前為他設計的一些智慧代理人,原本的目的就是協助他思考、挑戰論證、尋找可能的漏洞,結果這些工具真的在研究與寫作過程中幫上了一些忙。
不過,這一次的需求訪談,我也進一步知道了他最近面臨的一些狀況。
因為一些個人因素,他近期能投入論文修改的時間受到很大的壓縮,偏偏接下來又得準備國際期刊的論文內容,所以壓力其實相當大。
但如果把時間拉長來看,學員其實也有很深的自覺,覺得這次的契機是一件非常好的事情。
因為這次難得的機會,讓他的博士論文指導教授非常仔細地重新檢視了目前的論文內容,也提出了不少改進意見。而教授指出的這些問題,其實就像一面「照妖鏡」:它們不只是這一篇論文需要補強的地方,同時很可能也是未來進入博士論文 defense 時,口試委員最容易一路追問下去的入口。
換句話說,現在先被問出來,反而是一件好事。
只是,如同前面提到的,由於最近時間真的很有限,他短期內只能先處理一些相對容易修改的問題,例如句子、用字,或論述強度不夠精確的表達;又或者有些內容,其實他腦中已經有完整的想法,只是寫作時省略了中間的推論步驟、理由或定義。
這些問題雖然繁瑣,但至少知道該怎麼修。
真正棘手的,是教授另外提出的兩類問題。
第一類,是有些概念其實源自他自己的研究創見,因此他對既有定義做了一些調整。但一旦修改了原本大家熟悉的概念,讀者究竟能不能理解「你改了什麼、為什麼要改、這樣改之後又帶來什麼理論上的差異」,就變成一個很難處理的問題。
第二類則更常見:研究者自己對這個領域太熟了。
因此在寫作時,很容易下意識認為某些法規、制度、背景知識或專業術語「大家應該都知道」,於是直接跳過。但真正的讀者,尤其是跨領域 reviewer,未必具備相同的背景。
這兩類問題,就不是單純改幾個句子可以處理的了,而是得重新站到讀者的位置,檢查自己的概念、假設與推論到底少了什麼。對一個已經在這個領域裡泡了很多年的研究者而言,這反而是非常耗費腦力的工作。
也因為聽到了他正在面對這樣的難處,我們在訪談過程中開始產生一些想法:
有沒有可能把這些原本必須由研究者自己反覆進行的「換位思考」,交給 Agent 協助?
下面是我們會議中初步想到的幾個方向。
1. 建立「一般讀者模擬器」
研究者最難自行完成的事情之一,就是把自己從「已經非常熟悉研究內容的行家」位置抽離,重新用第一次讀到這篇論文的人的角度閱讀自己的文章。
所以我們想到,可以設計一個 Agent,不要求它替作者辯護,也不讓它預設作者寫的一定是對的,而是讓它扮演一個:
具有一般理解與推理能力,但沒有作者完整背景知識的讀者/reviewer。
這個 Agent 可以針對每一段,甚至每一個重要 statement,回報幾件事情:
-
它單純根據文章目前提供的文字,理解到的概念與定義是什麼。
-
它認為作者目前建立出的推論路徑是什麼。
-
它是怎麼從前一句理解到後一句的。
-
哪些地方它開始看不懂、產生歧義,或無法確認作者的意思。
-
哪些地方按照目前文字理解出來的結果,可能與作者真正想表達的事情不同。
-
如果要消除這些疑惑,它會想追問作者什麼問題。
重點不是讓 AI 直接把全文重寫一次。
真正有價值的是,讓研究者看見:
「如果我不是我自己,我會怎麼理解這段話?」
以及:
「讀者到底是從哪一個地方開始跟不上我的?」
某種程度上,這是在把研究者原本必須反覆在腦中進行的「讀者模擬」工作外部化。
2. 建立「領域背景批判檢視」
第二層則可以把 Agent 的背景知識再往上拉。
例如提供金融業、服務貿易、貿易法或其他相關領域知識,讓 Agent 站在「具有該領域背景的讀者」角度閱讀文章。
它要檢查的就不只是「我看不看得懂」,而是:
-
文章中的術語是否偏離該領域一般的專業用法。
-
哪些概念看起來是作者自行調整或重新定義過的。
-
哪些定義會讓熟悉該領域的人感到不直覺。
-
哪些地方需要補上原始定義,以及作者為何要修改它。
-
哪些論述本身存在專業爭議,不同立場的人可能會如何理解。
這裡有一點我覺得很重要。
研究者也提到,即使我們讓 Agent 查詢外部資料,它還是有可能判斷錯誤。
但如果連一個具備大量領域資訊的 Agent 都覺得某一段「很奇怪」,這個結果本身仍然具有價值。
因為它可能代表兩件事情:
一種可能是,研究者的邏輯真的缺了一塊,需要補強。
另一種可能則恰恰相反——研究者其實做出了一個與既有理解不同,而且值得明確主張的理論創新。
AI 的任務不應該替研究者決定究竟是哪一種。
它比較適合做的,是把這些「異常點」以及可能存在的不同觀點標示出來,最後仍然交由研究者進行理論判斷。
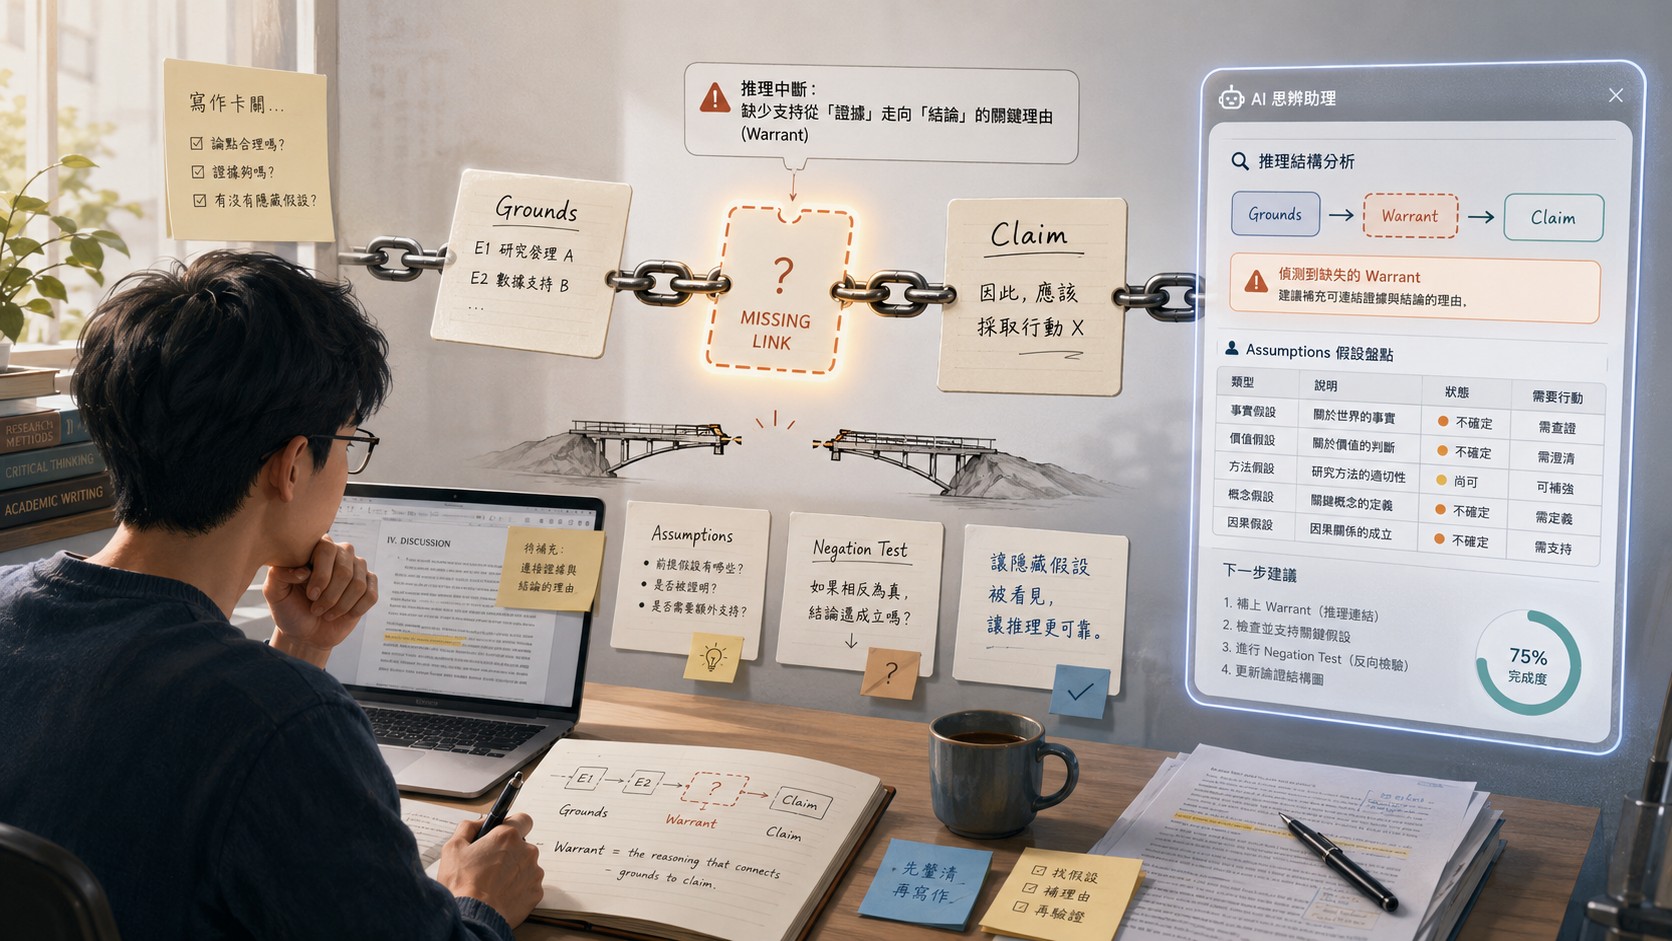
3. 產出「因果鏈與假設清單」
除了逐段指出問題之外,我們還想到,Agent 或許可以把整篇論文重新整理成兩份輔助文件。
因果鏈清單
把文章中的主要論證拆成一條一條可以檢查的鏈:
-
每一個主要主張的起點、推論過程與結論是什麼。
-
從一個命題跳到下一個命題時,有沒有缺少中間步驟。
-
每一個步驟所依賴的是資料、定義、文獻,還是某個沒有說明的理由。
-
哪些地方只是「寫得不夠清楚」。
-
哪些地方則可能真的存在論證上的缺口。
這樣研究者就不需要一直盯著整篇文章看,而是可以把原本藏在段落裡的推理骨架攤開來檢查。
假設清單
另一份則是把文章裡那些沒有被明講、卻默默支撐著整個論證的假設挖出來,例如:
-
這個假設的內容是什麼。
-
它支撐了哪一段推論。
-
如果把這個假設拿掉,後面哪些結論會跟著受到影響。
-
這個假設在該領域中屬於常見共識、具有爭議,還是高度不確定。
-
研究者是否應該在論文前段明確列出,或者至少在相關段落中補充說明。
這兩份文件最終甚至可以成為研究者整理正式 assumption section、重新檢查 conceptual framework,甚至準備 defense 時的輔助材料。
但它們的定位仍然不是「讓 AI 幫忙決定理論」。
而是:
讓原本藏在研究者腦中的推論、假設與知識背景,被攤在桌面上,變成一個可以逐項檢查的東西。
我自己覺得,這次訪談很有意思的一點是:
一開始我們想處理的,好像只是「論文怎麼改比較好」。
但一路往下拆之後才發現,真正困難的問題其實不是修改文字,而是:
研究者要怎麼知道,自己腦中那些「理所當然」的知識,究竟有哪些根本沒有被寫進論文裡?
而這件事情,也許正好是 Agent 很適合協助的一種工作。
不是替研究者寫論文,也不是替研究者做理論判斷,而是成為一面可以反覆切換角度的鏡子,把原本很難自己察覺的理解落差、隱含假設與論證斷點照出來。
不知道你有沒有遇過類似的問題?
當你已經對一個領域太熟悉,以至於很難再站回「第一次讀到這件事的人」的位置時,你通常會怎麼處理?
PS. 一般讀者模擬 Agent Skill 已經公開,你可以參考這裏: https://github.com/u8621011/research-skills